Confluence-Beratung · Wissensstruktur
Metadata for Confluence
Von Elevatic (früher Communardo Products), für Confluence Cloud und Data Center - ergänzt Seiten um strukturierte Metadatenfelder statt reinem Fließtext. Inhalte werden dadurch kategorisierbar, filterbar und auswertbar. Wir konzipieren die Kategorien und Felder passend zu Ihrer Wissensstruktur.
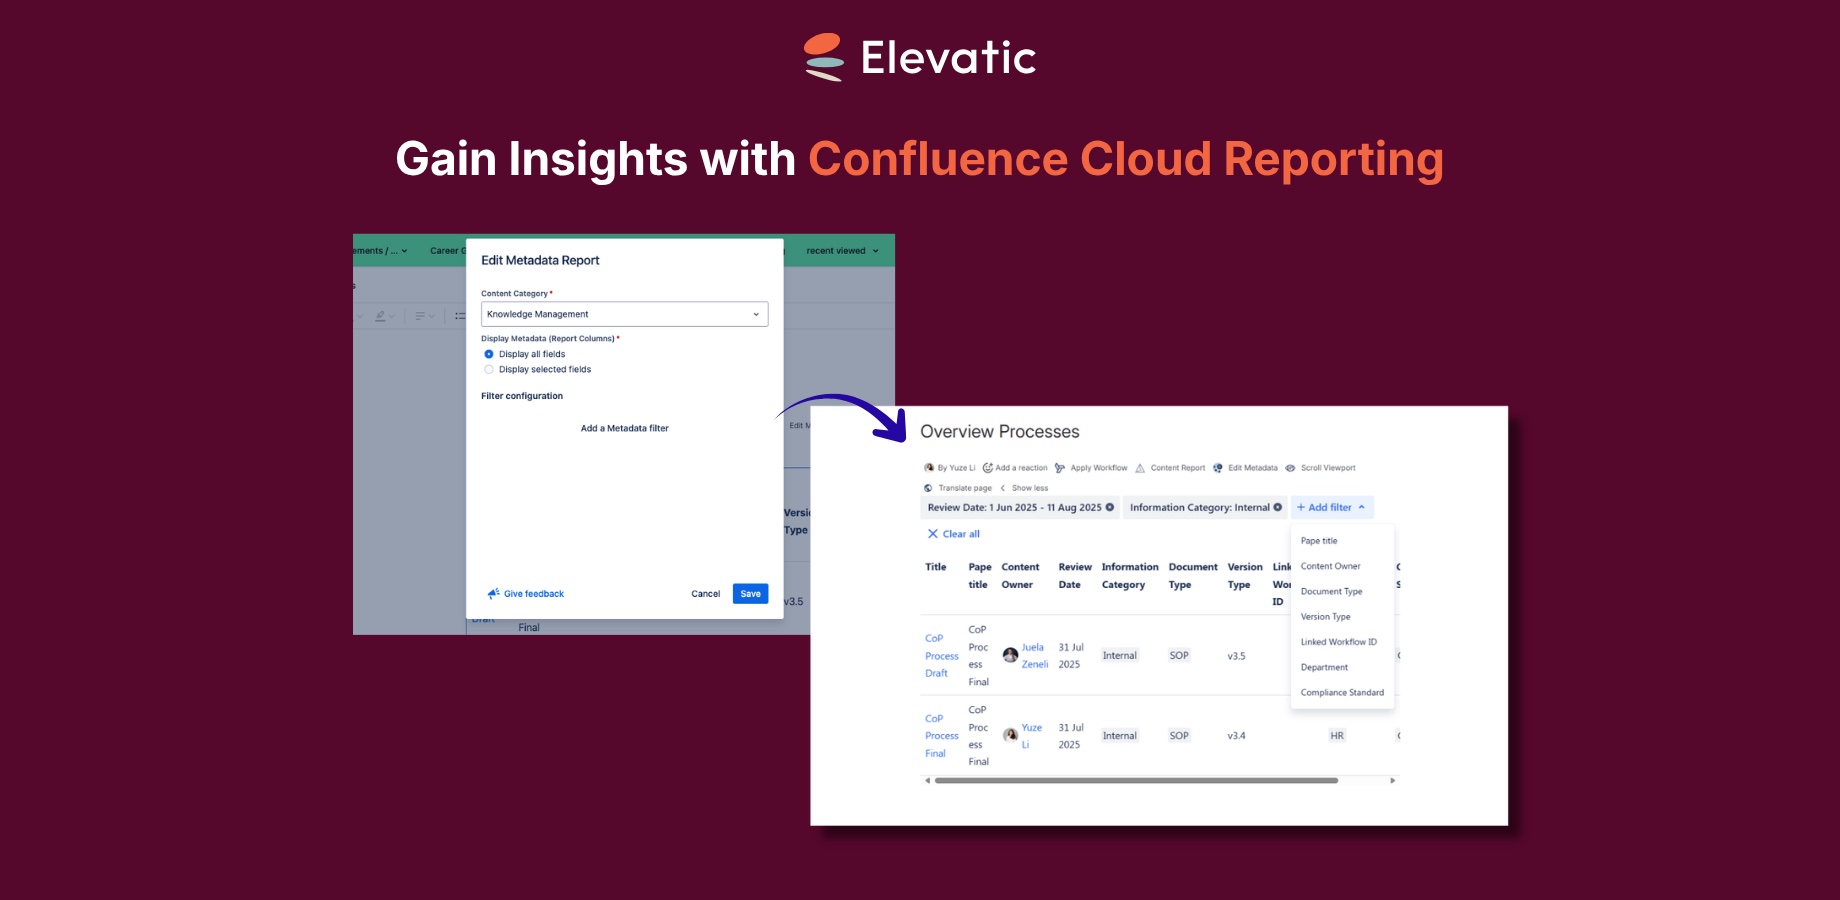
Automatisch aktualisierte Reports aus Metadaten
Metadatenfelder wie Content-Kategorie oder Review-Datum lassen sich einmal definieren und in Berichtstabellen mit Filtern wieder auswerten - ohne die Werte an zweiter Stelle nochmal zu pflegen.
Funktionsumfang
Was die App übernimmt
Content-Kategorien
Produkte, Projekte oder Prozesse bekommen frei definierbare Metadatenfelder statt loser Stichworte.
Frei definierbare Felder
Automatische Reports
Übersichten und Verzeichnisse aktualisieren sich automatisch aus den gepflegten Metadatenwerten.
Auswertbare Compliance-Dokumentation
Prozessdokumentation lässt sich nach Status oder Kategorie filtern und auswerten.
Integration mit Freigabe-Workflows
Auf Data Center lässt sich die App mit Comala-Workflows kombinieren, sodass Status und Metadaten zusammenspielen; in der Cloud gibt es diese Integration nicht.
Frei definierbare Feldtypen
Text-, Auswahl- und Datumsfelder lassen sich je Kategorie unterschiedlich anlegen.
Skalierbar für große Wikis
Auch bei mehreren tausend Seiten bleiben Inhalte über Metadaten auffindbar, nicht nur über die Ordnerstruktur.
Was das für Sie bedeutet
Drei Blickwinkel auf dieselbe Wissensstruktur.
- Geschäftsführung: Wissen bleibt auffindbar, auch wenn das Wiki über Jahre wächst - Struktur skaliert mit, statt mit der Zeit unübersichtlich zu werden.
- IT & Sicherheit: Strukturierte Felder lassen sich leichter auf Vollständigkeit und Aktualität prüfen als freier Fließtext.
- Fachbereich: Wer eine Information sucht, filtert nach Kategorie statt Stichwörter zu erraten.
Typischer Einsatz
Die App lohnt sich, sobald ein Wiki zu groß wird, um Inhalte nur über die Volltextsuche wiederzufinden.
- Produkt- oder Systemkataloge, die automatisch aus gepflegten Metadaten entstehen.
- Compliance- und Prozessdokumentation mit auswertbarem Status.
- Große Wikis, in denen Inhalte nach Kategorie filterbar sein müssen statt nur durchsuchbar.
Häufige Fragen zu Metadata for Confluence
Gibt es eine Cloud-Version?
Ja, mit reduziertem Umfang. In der Cloud heißen Metadata Sets 'Content Categories', pro Seite gilt eine Kategorie, Blogposts sind ausgenommen. Es fehlen unter anderem Historie, Bulk-Change und CQL-Filter sowie die Comala-Integration - ob die Cloud-Version Ihre Anforderungen abdeckt, prüfen wir vor der Einführung. Data Center ist von Atlassian abgekündigt (kein Neuverkauf seit 30.03.2026, End-of-Life 28.03.2029) - für neue Umgebungen ist die Cloud-Version der Weg.
Ersetzt das eine echte Datenbank?
Für strukturierte Inhalte innerhalb von Confluence ja. Für komplexe relationale Daten mit vielen Verknüpfungen bleibt eine dedizierte Datenbank oder ein Fachsystem die bessere Wahl.
Wie viel Aufwand macht die Einführung?
Der größte Teil der Arbeit liegt in der Kategorien- und Feldstruktur, nicht in der App selbst - wir konzipieren das gemeinsam mit den Teams, die die Inhalte später pflegen.
Wie unterscheidet sich das von Labels in Confluence?
Labels sind freie Stichworte ohne Struktur. Metadata for Confluence bringt definierte Felder mit festen Werten und Typen - dadurch werden Auswertungen und automatische Reports erst möglich.